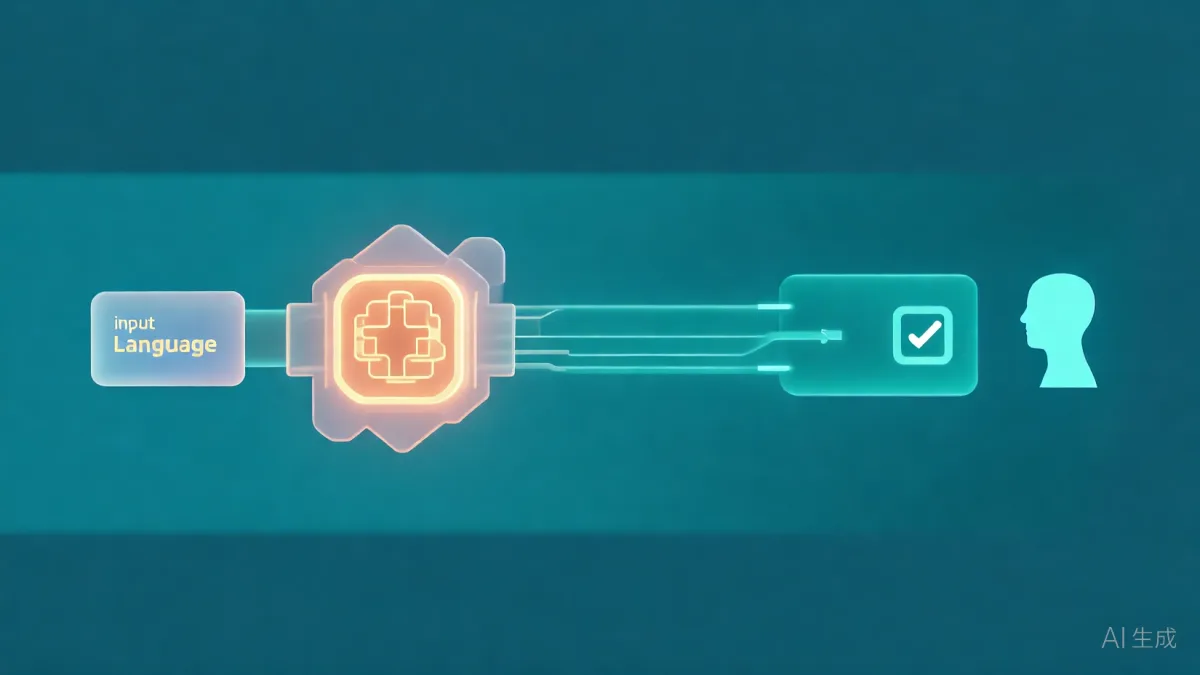
وقتی تیم توسعه تصمیم میگیرد از مدل زبانی بزرگ (Large Language Model) در محصول استفاده کند، معمولاً همهچیز با یک دموی درخشان شروع میشود و چند هفته بعد با یک باگ عجیب گره میخورد: همان ورودی که دیروز جواب درست میداد، امروز جواب دیگری میدهد. این مقاله دربارهٔ همان فاصله است؛ فاصلهٔ میان دمو و مؤلفهای که میتوان با خیال راحت آن را در نرمافزار سازمانی گذاشت.
مدل زبانی بزرگ یک تابع معمولی نیست
در کد روزمره، یک تابع با ورودی مشخص همیشه خروجی مشخصی میدهد. مدل زبانی بزرگ اینطور نیست: خروجی آن احتمالمحور است، به کوچکترین تغییر در متن دستور واکنش نشان میدهد و با تغییر مدل یا تنظیمات، رفتارش جابهجا میشود. سه پیامد عملی دارد:
- تست واحد به شکل همیشگی جواب نمیدهد. نمیتوانید انتظار داشته باشید خروجی دقیقاً برابر یک رشته ثابت باشد.
- هزینه و تأخیر متغیر است. طول ورودی و خروجی، هر دو بر زمان پاسخ و مصرف تأثیر میگذارند.
- رفتار با گذشت زمان جابهجا میشود. دادهای که به مدل میدهید تغییر میکند و مدل هم ثابت نمیماند.
نتیجه ساده است: با مدل زبانی نباید مثل یک کتابخانهٔ قطعی رفتار کرد؛ باید مثل یک سرویس بیرونی که ممکن است پاسخ نامعتبر بدهد، با آن برخورد کرد.
قرارداد بنویسید، نه فقط دستور متنی
بیشتر تیمها کار را با نوشتن یک دستور متنی (prompt) طولانی شروع میکنند و آن را در چند جای کد تکرار میکنند. راهِ سالمتر این است که اول قرارداد را مشخص کنید: مدل چه چیزی میگیرد و دقیقاً چه چیزی باید برگرداند.
- ورودی ساختارمند. بهجای چسباندن متن خام، فیلدهای مشخص بفرستید: عنوان درخواست، توضیح کاربر، شناسه مشتری، فهرست برچسبهای مجاز.
- خروجی ساختارمند. از مدل بخواهید در قالب یک ساختار مشخص (مثلاً JSON) پاسخ دهد و برای «نمیدانم» یک مقدار صریح داشته باشد؛ وادار کردن مدل به حدس زدن، خطای خاموش میسازد.
- اعتبارسنجی طرحواره (schema validation). هر پاسخ، پیش از استفاده، باید از یک لایهٔ اعتبارسنجی بگذرد: نوع فیلدها، دامنهٔ مقادیر مجاز، طول متن و ارجاع به موجودیتهای واقعی سیستم.
- مسیر جایگزین (fallback). اگر پاسخ نامعتبر بود یا فیلد «نمیدانم» پر شد، سیستم باید یک رفتار تعریفشده داشته باشد: یک تلاش دوبارهٔ محدود، سپس صف انسانی یا منطق قطعی.
الگوی «پیشنهاد و تصمیم»
قابلاعتمادترین کاربرد مدل زبانی در نرمافزار سازمانی، جایی است که مدل فقط پیشنهاد میدهد و کد شما تصمیم میگیرد. نمونهٔ روشن، دستهبندی و اولویتدهی درخواستهای پشتیبانی است: مدل موضوع را تشخیص میدهد و برچسب پیشنهاد میدهد؛ اما اولویت نهایی و مسیر ارجاع را قواعد قطعی تعیین میکنند — سطح قرارداد مشتری، مهلت پاسخگویی، تخصیص به تیم مربوطه. اگر مدل با اطمینان پایین پاسخ داد، درخواست به صف بازبینی انسانی میرود.
این جداسازی، هم قابل حسابرسی است و هم قابل اصلاح: اگر دستهبندی اشتباه شد، میتوانید لایهٔ پیشنهاد را عوض کنید بدون آنکه منطق کسبوکار آسیب ببیند. در سامانههایی که چرخهٔ درخواست و ارجاع، قلب محصول است، همین مرز، تفاوت میان یک قابلیت قابل اتکا و یک منبع شکایت است؛ سامانهٔ تیکتینگ و مدیریت پشتیبانی نمونهای است که این مرز در آن معنا پیدا میکند.
کجا اصلاً سراغ مدل زبانی نرویم
بخشی از هزینهٔ پروژههای هوش مصنوعی، صرف حل مسائلی میشود که اصلاً به مدل زبانی نیاز نداشتند. این فهرست کوتاه را قبل از شروع بررسی کنید:
- قاعدهٔ صریح دارید. اگر منطق را میتوانید در چند شرط بنویسید، همان را بنویسید؛ سریعتر، ارزانتر و قابل ردیابی است.
- دادهٔ برچسبدار و دستههای محدود دارید. برای طبقهبندی روی مجموعهای ثابت از برچسبها، مدلهای کلاسیک یادگیری ماشین قابل پیشبینیترند.
- خروجی باید قطعی و قابل محاسبه باشد. جمعها، مالیات، مانده حساب و قواعد پرداخت را به موتور محاسبه بسپارید، نه به متن تولیدشده.
- حجم بالا با تأخیر کم میخواهید. وقتی هر درخواست باید در کسری از ثانیه جواب بگیرد، فراخوانی مدل زبانی گران و کند است.
- دادهٔ حساس داری و راه پاکسازی نداری. تا وقتی مشخص نکردهاید چه چیزی از سیستم بیرون میرود، ارسال نکنید.
کیفیت را چطور بسنجیم؛ بدون دادهٔ طلایی بزرگ
بدون سنجش، هر تغییر در دستور متنی یک قمار است. لازم نیست مجموعهدادهٔ عظیم بسازید؛ یک مجموعهٔ ارزیابی (evaluation set) کوچک از نمونههای واقعی — چند ده تا چند صد مورد که پاسخ درستشان را میدانید — کافی است تا رگرسیون بگیرید. سه معیار کاربردی:
- نرخ پذیرش: چند درصد پاسخها از اعتبارسنجی و بازبینی انسانی سالم بیرون میآیند.
- نرخ خطای پرهزینه: پاسخهایی که هزینهٔ واقعی دارند (ارجاع به تیم اشتباه، برچسب حساس، ادعای بیپشتوانه). این عدد مهمتر از میانگین دقت است.
- نرخ «نمیدانم»: مدلی که همیشه جواب میدهد، خطرناکتر از مدلی است که گاهی عقب میکشد.
هر تغییر در دستور متنی یا مدل باید از همین مجموعه عبور کند. ثبت لاگ ورودی و خروجی هم لازم است، هم برای اشکالزدایی و هم برای اینکه مجموعهٔ ارزیابی با نمونههای تازه رشد کند. اگر این کار را جدی بگیرید، مدل زبانی به یک مؤلفهٔ معماری تبدیل میشود، نه یک جعبهٔ سیاه؛ همان مسیری که در معماری نرمافزار مبتنی بر مدل زبانی باید طی شود.
هزینه، تأخیر و جای انسان
دو اهرم ساده، بیشترین اثر را روی هزینه و تأخیر دارند: کش کردن پاسخهای تکراری و شکستن کار به مراحل کوچک، بهطوری که بخشی از آن با منطق قطعی یا مدل سبکتر انجام شود. همچنین طول ورودی را جدی بگیرید؛ فرستادن کل تاریخچهٔ مکالمه به مدل، گران و کمفایده است.
و در آخر، جای انسان را در طراحی باز بگذارید. هر جا تصمیم هزینهبر است — رد درخواست، تغییر وضعیت مالی، پاسخ به مشتری حساس — یک نقطهٔ بازبینی انسانی بگذارید. هوش مصنوعی در این معماری، وظیفهها را جابهجا میکند نه شغلها را؛ و همین نگاه، پذیرش سیستم را در سازمان بسیار سادهتر میکند.
جمعبندی
مدل زبانی بزرگ ابزار خوبی است، به شرطی که با آن مثل یک سرویس احتمالی رفتار کنید: قرارداد روشن، خروجی ساختارمند، اعتبارسنجی سختگیرانه، مسیر جایگزین تعریفشده و مجموعهٔ ارزیابی کوچک اما جدی. با این پنج عادت، خروجی غیرقطعی مدل به یک قابلیت قابل اتکا در محصول تبدیل میشود؛ بدون آنها، هر بار که مدل عوض میشود، باید از نو به سیستم اعتماد کنید.