استفاده از مدلهای زبانی بزرگ (Large Language Model) در نرمافزار خیلی زود از مرحلهٔ «یک بار امتحان کنیم ببینیم چه میشود» گذشته است. امروز کمتر تیم فنیای هست که با آن کار نکرده باشد. اما شکاف اصلی جای دیگری است: بیشتر تیمها یاد گرفتهاند چگونه از مدل سؤال بپرسند و کمتر تیمهایی یاد گرفتهاند چگونه مدل را بهعنوان یک قطعهٔ نرمافزاری — با قرارداد، خطا، آزمون و هزینه — به سیستم وصل کنند. این مقاله سراغ همین شکاف میرود.
سه جایگاه متفاوت، سه سطح ریسک
اولین اشتباه رایج، یککاسهکردن سه کاربرد متفاوت است. مدل زبانی در نرمافزار معمولاً یکی از این سه نقش را دارد:
- ابزار توسعهدهنده: پیشنهاد کد، تولید تست، بازبینی، توضیح کد ناآشنا. ریسکش این است که کد اشتباه، اما روان و مطمئن، وارد مخزن شود. در این نقش، مدل جای همکار باسابقه را نمیگیرد؛ جای یک پیشنویسنویس سریع را میگیرد. تجربهٔ کار با دستیار کدنویسی و انتخاب مدل مناسب نشان میدهد کیفیت خروجی بیشتر به نحوهٔ بازبینی ما وابسته است تا به خود مدل.
- قابلیت محصول: خلاصهسازی، جستوجوی معنایی، پیشنویس پاسخ، تبدیل متن آزاد به داده ساختاریافته. اینجا مدل بخشی از تجربهٔ کاربر است و خطایش دیده میشود.
- موتور فرایند: تصمیمگیری در جریان کار، مانند مسیریابی درخواستها یا استخراج اطلاعات از اسناد. این نقش پرریسکترین است، چون خروجی مدل مستقیماً کاری را در سیستم آغاز میکند.
هر سه نقش مشروعاند، اما سطح کنترل و آزمونشان یکی نیست. تیمی که این سه را از هم جدا نکند، معمولاً سختگیرترین کنترلها را روی بیخطرترین کاربرد میگذارد و آسانگیرترین را روی پرخطرترین.
مدل زبانی یک تابع احتمالاتی است، نه یک کتابخانه
تفاوت بنیادی مدل با بقیهٔ اجزای نرمافزار این است که برای ورودی یکسان میتواند خروجی متفاوت بدهد و درستی خروجی را نمیتوان از روی ظاهر متن تشخیص داد. مدل، دانشش را از توزیع آماری متن گرفته است؛ چیزی که پرتکرار بوده را خوب میداند و چیزی که کمتکرار یا تازه باشد را با همان لحن مطمئن، اشتباه میگوید.
قاعدهٔ عملی ساده است: مدل زبانی را همانجایی بگذارید که یک سرویس خارجی را میگذارید — با زمانسنج، تلاش مجدد و مسیر جایگزین؛ نه جایی که خروجیاش بیدرنگ و بدون بازبینی اثر قطعی میگذارد. تبدیل هوش مصنوعی مولد از دمو به فرایند قابل اتکا بیشتر از انتخاب مدل، به همین مرزبندی بستگی دارد.
قرارداد خروجی: از متن آزاد به داده ساختاریافته
اگر از مدل بخواهید خروجی را در قالب داده ساختاریافته (structured output) بدهد، نیمی از راه رفتهاید؛ نیم دیگر، اعتبارسنجی است. یک حلقهٔ کاری قابل اتکا معمولاً این شکل را دارد:
- ساختار خروجی را صریح تعریف کنید: فیلدهای مشخص، دامنهٔ مقادیر مجاز، و صراحت در اینکه مدل اگر مطمئن نیست باید مقدار «نامشخص» بدهد.
- خروجی را در کد اعتبارسنجی کنید: نوع فیلدها، دامنهٔ مجاز، و مهمتر از همه، وجود شناسههایی که مدل برگردانده در پایگاه دادهٔ واقعی.
- اگر اعتبارسنجی شکست خورد، یک بار دیگر با پیام خطای دقیق از مدل بخواهید اصلاح کند.
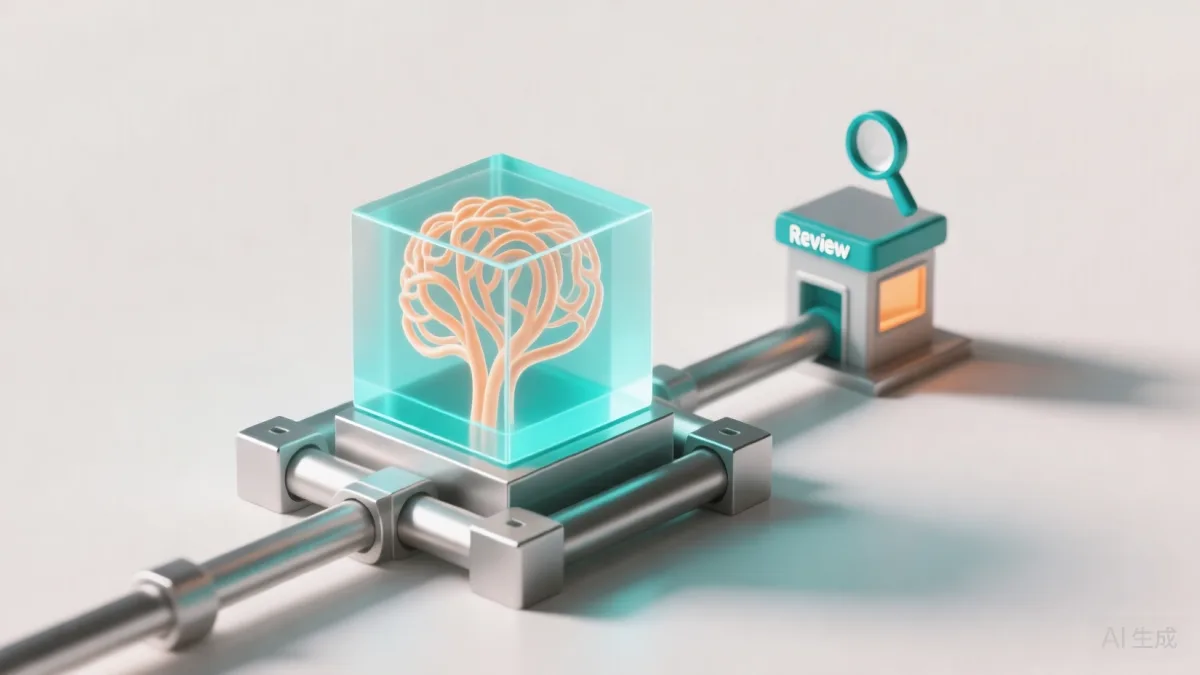
- اگر بار دوم هم شکست خورد، به مسیر جایگزین بروید: صف بازبینی انسانی یا یک مقدار پیشفرض محافظهکارانه.
- نتیجهٔ اعتبارسنجی را ثبت کنید؛ این عدد، معیار کیفیت واقعی سیستم شماست، نه حسوحال یک دمو.
همین حلقه است که تفاوت محصول و نمونهٔ نمایشی را میسازد. مدل میتواند اشتباه کند؛ سیستم نباید بهخاطر آن از کار بیفتد یا دادهی غلط را قطعی جا بزند.
مثال عملی: دستهبندی و خلاصهسازی تیکت پشتیبانی
فرض کنید میخواهیم از تیکتهای خام فارسی، چهار چیز بیرون بکشیم: دسته، فوریت، یک خلاصهٔ یکخطی و پیشنویس پاسخ. طراحی معقول، تقسیم اختیار بر اساس هزینهٔ خطاست:
- دسته و فوریت: خودکار اعمال میشوند، چون خطایشان ارزان و قابل اصلاح است و اپراتور میتواند آن را تغییر دهد.
- خلاصه: با محدودیت طول و با تأکید بر اینکه مدل نباید ادعای تازهای به متن اضافه کند.
- پیشنویس پاسخ: هرگز بهطور خودکار ارسال نمیشود؛ فقط پیشنهاد است. اگر مدل باید از دانشنامهٔ داخلی استفاده کند، پاسخ را بر پایهٔ مقالهٔ بازیابیشده بسازید و ارجاع را اجباری کنید تا وعدهٔ بیپشتوانه ساخته نشود.
همین منطق در سامانههایی که تماسها را با اپراتور هوش مصنوعی مدیریت میکنند هم برقرار است: هوشمندی در لایهٔ پیشنهاد، و اختیار نهایی در جای مشخص.
آنچه پیش از انتشار باید اندازه بگیرید
پرامپت را مثل کد مدیریت کنید: نسخهبندی، بازبینی و آزمون. یک مجموعهٔ آزمون کوچک از چند ده نمونهٔ واقعی بسازید و هر تغییر در پرامپت یا مدل را با آن بسنجید. حداقل اینها را اندازه بگیرید:
- دقت دستهبندی در مقایسه با برچسب انسانی
- نرخ خروجی نامعتبر و نرخ ارجاع نادرست
- زمان پاسخ در حالت میانه و در بدترین حالت
- هزینهٔ متغیر به ازای هر واحد درخواست
در کنار اینها، چارچوبهای مدیریت ریسک هوش مصنوعی کمک میکنند محدودهٔ کاربرد و سطح نظارت انسانی را از پیش روشن کنید، نه بعد از حادثه.
دو هزینهٔ پنهان را هم فراموش نکنید: هزینهٔ نگهداری (هر تغییر در فرایند، پرامپت را هم تغییر میدهد) و وابستگی به یک ارائهدهنده. یک لایهٔ انتزاع داخلی بسازید تا تعویض مدل، بازنویسی کل سیستم نباشد. در ثبت ورودی و خروجی هم دقت کنید؛ ذخیرهٔ متن خام میتواند دادهٔ شخصی را در جای تازهای تکثیر کند، همانطور که در کمترین داده و کمترین دسترسی بحث شده است.
چه چیزهایی را به مدل نسپاریم
مدل زبانی در تبدیل زبان به ساختار، خلاصهسازی، پیشنهاد و تولید متن قابل بازبینی خوب است و در دقت عددی، حافظهٔ دقیق و محاسبهٔ قطعی بد. پس:
- محاسبات مالی، مالیات، تاریخ و جمعها را در کد بنویسید، نه در پرامپت.
- تصمیم نهایی مانند رد اعتبار یا مسدودسازی حساب را به قاعدهٔ صریح و بازبینی انسانی بسپارید.
- به مدل اجازهٔ اجرای بیواسطهٔ عملیات ندهید؛ خروجیاش را ابتدا اعتبارسنجی و سپس اجرا کنید.
جمعبندی: چهار پرسش قبل از هر خط کد
پیش از آنکه مدل را به محصول وصل کنید، چهار پرسش را پاسخ دهید: اگر مدل خطا کند، چه کسی و چه زمانی متوجه میشود؟ خروجیاش بازبینی انسانی دارد یا مستقیم اثر میگذارد؟ میتوان آن را ماشینی اعتبارسنجی کرد؟ و اگر فردا مدل را عوض کنیم، چه چیزی میشکند؟ اگر پاسخ این پرسشها روشن نیست، هنوز دمو دارید، نه قابلیت. ارزش واقعی مدل زبانی در نرمافزار وقتی آزاد میشود که آن را نه بهعنوان یک جعبهٔ جادویی، بلکه بهعنوان یک مؤلفهٔ نامطمئن اما بسیار مفید، با قرارداد و حفاظ، در معماری جای داده باشیم.